AI Nieuws Vandaag
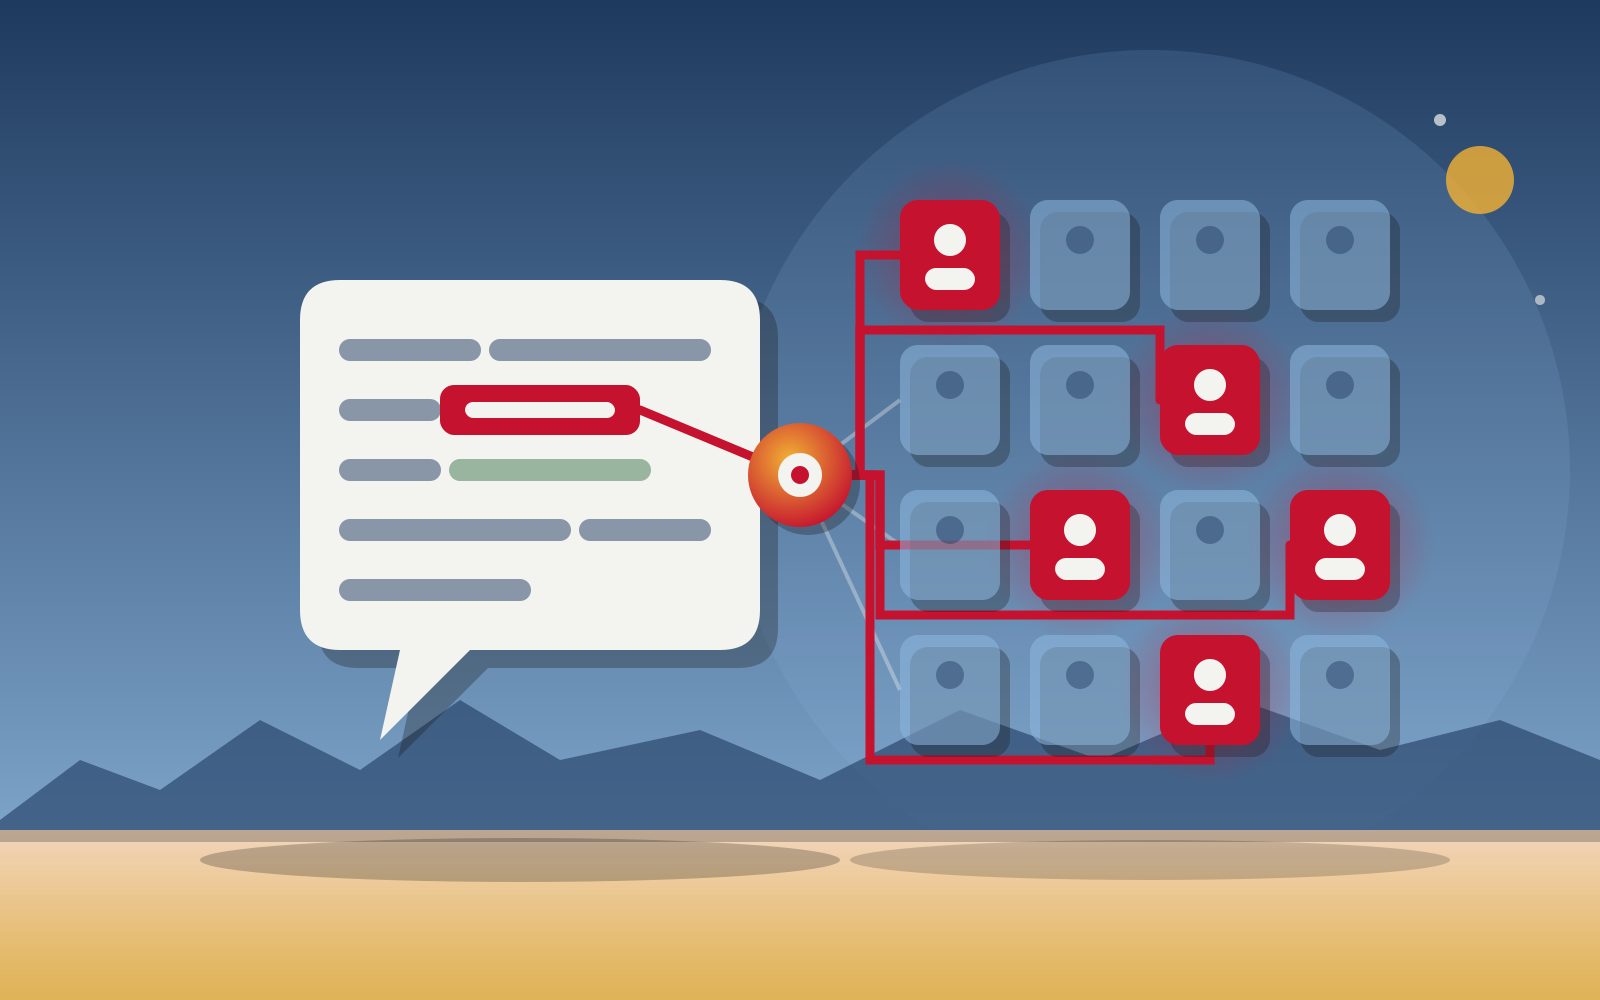
Zo werkt een AI-model dat per woord andere experts kiest
Een mixture-of-experts is een AI-model dat uit veel deelmodellen bestaat, experts genoemd, waarvan er bij elk stukje tekst maar een paar meewerken. Mistral Large 4 is zo gebouwd: het kiest per stukje tekst vijf experts uit een grote groep.
Wat heb je eraan: Je snapt hierdoor waarom een model met een biljoen parameters toch sneller kan werken dan je zou verwachten, omdat telkens maar een deel actief is.
Denk aan een ziekenhuis waar de balie je naar de juiste specialisten stuurt in plaats van alle artsen tegelijk te laten meekijken. Zo kiest het model bij elk stukje tekst een paar deelmodellen die het werk doen.
Wat is een mixture-of-experts?
Op een krantenredactie leest de eindredacteur elk stuk en stuurt het door naar sport, economie of buitenland. Niet elke journalist hoeft alles te lezen. Dat bespaart veel tijd.
Een mixture-of-experts werkt zo ook. Het AI-model bestaat uit veel kleine deelmodellen, de experts. Een onderdeel dat de router heet, kiest per stukje tekst welke experts meewerken.
De andere experts blijven in die ronde stil. Daardoor gebruikt het model per stukje tekst maar een deel van zichzelf. Dat scheelt rekenwerk.
Hoe kiest de router de experts in een model?
Een stukje tekst heet een token: een woord of een deel van een woord waarmee het model rekent. Voor elk token geeft de router elke expert een score. De experts met de hoogste score doen mee.
Niemand wijst die taken vooraf toe. Het model leert tijdens het trainen zelf welke expert waarvoor goed is. Daarom lijken experts niet altijd op nette vakgebieden als sport of recht.
Mistral Large 4 is op deze manier gebouwd. De router kiest per token een klein groepje uit een grote groep. Daardoor blijft het model vlot, ook al heeft het enorm veel parameters, de instellingen die bepalen wat het kan.
Wat merk je als gebruiker van een mixture-of-experts?
Je merkt vooral dat een groot model sneller antwoordt dan je zou verwachten. Omdat telkens maar een deel werkt, kost elk antwoord minder rekenwerk. Dat kan ook goedkoper zijn voor wie zo'n model draait.
Er is wel een keerzijde. Alle experts moeten in het geheugen van de computer staan, ook als ze even niet meedoen. Dus heb je voor een heel groot model nog steeds een flinke server nodig.
Kijk bij een nieuw model daarom naar twee getallen: het totaal aantal parameters en het aantal dat per token meedoet. Het tweede zegt meer over de snelheid, het eerste over wat het model in huis heeft. Noemt een bedrijf maar één getal, dan weet je nog niet hoe snel het model is.
Mistral maakt zijn grootste model Large 4 vrij te downloaden
Gemeld door 3 bronnen: Mistral, Hugging Face blog, NOS Tech
Lees de bron (naar de bron)Klopt er iets niet?
Onderwerpen: MistralOpen modellen
Elke ochtend het AI-nieuws in je mail
Om 07:00 de belangrijkste berichten, in gewone taal. Gratis, en afmelden kan altijd met één klik. Je meldt je aan bij Buttondown, de dienst die de nieuwsbrief voor ons verstuurt.