AI Nieuws Vandaag
Zo werkt een veiligheidsfilter in een AI-model
Een veiligheidsfilter is een controle die een AI-model laat weigeren als een vraag riskant lijkt. Dat speelt nu omdat zulke filters testscores omlaag kunnen trekken en gebruikers soms laten stuiten op een weigering.
Wat heb je eraan: Je snapt waarom een model soms niet meewerkt en waarom de keuze voor het beste model per taak kan verschillen.
Denk aan een baliemedewerker die bij een vreemde vraag eerst even in het protocol kijkt en soms nee zegt. Zo kan een AI-model weigeren, ook als jij een goede reden hebt.
Wat doet een veiligheidsfilter in een AI-model?
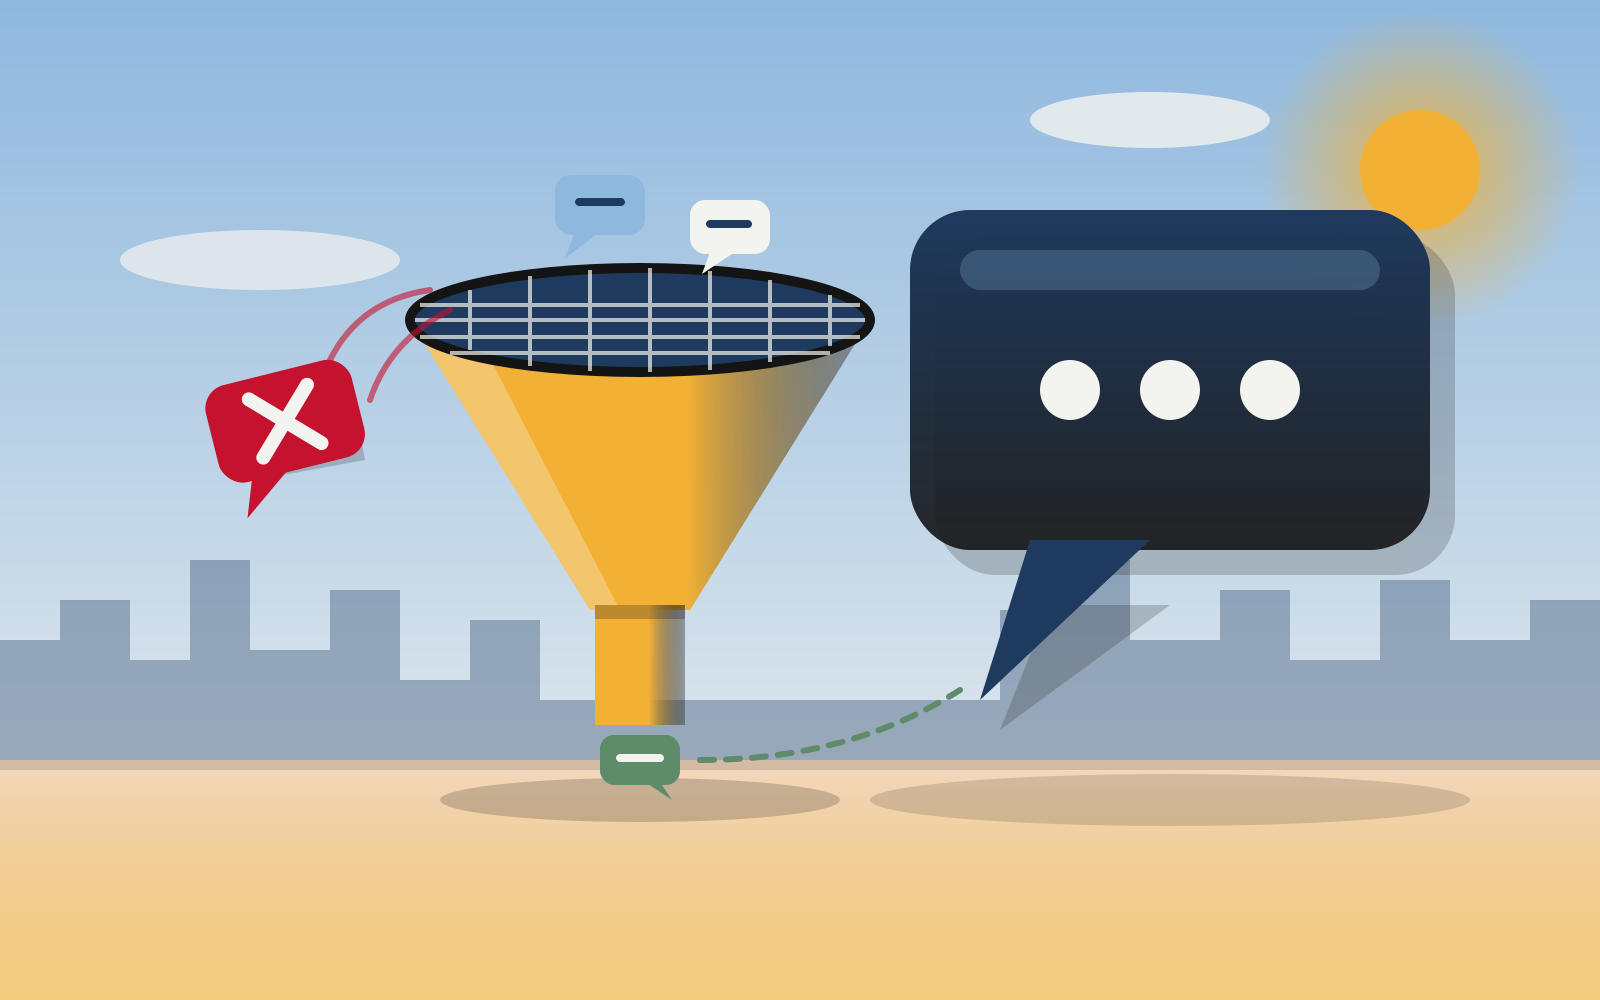
Wie ChatGPT of Claude weleens iets vraagt en een beleefde weigering krijgt, heeft zo'n filter gezien. Een veiligheidsfilter is een extra controle naast het model zelf. Hij kijkt of een vraag of taak gevaarlijk kan zijn.
Het werkt als een sluis voor het antwoord. Het model krijgt een opdracht en de controle beoordeelt of die op een risico lijkt, bijvoorbeeld op hulp bij een aanval of bij gevaarlijke stoffen. Lijkt het riskant, dan weigert het model of geeft het een afgezwakt antwoord.
De makers stellen zo'n filter strikt in, omdat misbruik veel schade kan doen. Daardoor let hij op kenmerken van een vraag en niet op jouw bedoeling. Een onschuldige vraag over een gevoelig onderwerp kan dus ook geblokkeerd worden.
Waarom drukt een veiligheidsfilter testscores omlaag?
Een test geeft een model taken en telt alleen wat goed is. Weigert het model een taak, dan krijgt het geen punten. Het maakt voor de score niet uit of het model het kón of het niet mócht.
Dat zie je terug bij de nieuwe test GDPx. Volgens SemiAnalysis halen Opus 5.5 en GPT-6 Astra een lagere totaalscore door hun filters, vooral bij cyberbeveiliging, biologie en afstemming. Zonder die drie gebieden ziet de ranglijst er anders uit.
Het is een bewering van het bedrijf dat de test maakte, en onafhankelijke controle noemt de bron niet. Toch laat het zien dat een lage score twee dingen kan betekenen. Het model kan het niet, of het wil het niet.
Wat kun je doen als een AI-model weigert?
Leg eerst uit waarom je iets vraagt. Een zakelijke of schoolse reden maakt voor het model vaak duidelijk dat je geen kwaad wilt. Formuleer de vraag ook zo concreet mogelijk, zodat er minder te raden valt.
Blijft het model weigeren, probeer dan een ander model. Filters verschillen per bedrijf, dus wat het ene model afwijst, doet het andere soms wel. Ga daarbij nooit een waarschuwing te lijf en probeer het filter niet te omzeilen.
Kies je een model voor werk in één vakgebied, kijk dan naar de score op dat gebied. Let ook op of een lage score komt door weigeren. Zo weet je beter wat een cijfer echt zegt.
Gemeld door 1 bron: SemiAnalysis (via Techmeme)
Lees de bron (naar de bron)Klopt er iets niet?
Onderwerpen: AI-veiligheid
Elke ochtend het AI-nieuws in je mail
Om 07:00 de belangrijkste berichten, in gewone taal. Gratis, en afmelden kan altijd met één klik. Je meldt je aan bij Buttondown, de dienst die de nieuwsbrief voor ons verstuurt.